
TP 3. Alineamientos de secuencias de a pares
Atención: Este TP tiene informe.
Atención: Este TP tiene parcialito.
Objetivos
- Entender el funcionamiento básico del algoritmo de alineamiento de pares de secuencias de Needleman-Wunsch.
- Aprender a interpretar un Dot-Plot, pudiendo identificar las regiones relevantes que contienen patrones.
- Comprender los conceptos de identidad, similitud y homología de secuencias, y establecer una clara diferencia entre los mismos.
Introducción
El alineamiento de secuencias de a pares comprende la asignación uno-a-uno de correspondencias entre los elementos que componen dichas secuencias sin alterar su orden. En dicho proceso tres eventos principales pueden tener lugar:
- Match (M): Cuando los elementos enfrentados son equivalentes.
- Mismatch (m): Cuando los elementos correspondientes son diferentes.
- Gap (g): Cuando un elemento de una secuencia no tiene par en la otra y se enfrenta a un espacio, caracterizado por un guión (-).
- Gap open: Cuando se abre un gap.
- Gap extend: Cuando se agregan gaps a continuación de otro gap.
Por ejemplo, si alineamos las secuencias AFGIVHKLIVS y AFGIHKIVS un posible resultado sería:
A F G I V H K L I V S
A F G I - H K - I V S
Los gaps no existen en la realidad. NO son un aminoácido o nucleótido más, sino una herramienta que utilizamos para poder alinear.
La principal función de los alineamientos es establecer una medida de similitud entre las secuencias que participan en el mismo. Para ello es necesario definir un sistema de puntuación que pese cada uno de los eventos que tienen lugar en la construcción del alineamiento. Asimismo, este esquema de puntajes o scoring nos permitirá optimizar el alineamiento de forma tal que los algoritmos empleados elijan la correspondencia entre secuencias que maximice el puntaje o score global.
Existen varios algoritmos de alineamiento:
-
Los alineamientos globales (o de Needleman-Wunsch por sus creadores), se realizan apareando todos los elementos de una secuencia con todos los elementos de la otra. Este tipo de alineamientos se utiliza principalmente para comparar dos secuencias que son similares en longitud.
-
Los alineamientos locales (o de Smith-Waterman), parean únicamente parte de las secuencias y son útiles para identificar, por ejemplo, dominios en común.
-
Los alineamientos mixtos, que combinan los dos anteriores.
Dynamic programming
Dado un par de secuencias y un sistema de puntuación o scoring se pueden aplicar diversos algoritmos para encontrar el alineamiento que dé el mejor puntaje.
El algoritmo más popular utiliza un método matemático llamado dynamic programming. El mismo consiste en comparar ambas secuencias construyendo una matriz del alineamiento. Brevemente:
- Se comienza en el extremo superior izquierdo de la matriz, con un puntaje inicial de 0.
- En cada paso, se calcula el costo que tiene aparejado desplazarse de una celda a la otra, dado el sistema de puntajes pre-establecido, y se elige la opción más favorable, es decir aquella que maximice el puntaje global del alineamiento.
- En cada iteración se guarda el puntaje con el que se llegó a una celda dada y el movimiento que originó dicho camino o path, indicado típicamente con una flecha. Una vez que la matriz está completa en su totalidad se puede recorrer hacia atrás o realizar un traceback, desde el extremo inferior derecho al superior izquierdo, para reconstruir el alineamiento.
La principal ventaja de este método es que siempre encuentra el alineamiento óptimo entre las secuencias dadas.
Sin embargo, una desventaja es que pueden existir varios alineamientos que satisfagan esta condición.
Otra desventaja es de origen técnica: la exhaustividad con la que el algoritmo realiza la búsqueda hace que su velocidad dependa de la longitud de las secuencias implicadas, haciendo poco eficiente la búsqueda de similitud de una secuencia contra una base de datos. Para esto existen diferentes adaptaciones del algoritmo que se verán más adelante.
Ejemplo
Imaginen que queremos alinear las secuencias TCGCA y TCCA utilizando un esquema de scoring de:
- Match: M=1
- Mismatch: m=-1
- Gap: g=-2
Para eso ubicamos las secuencias en una matriz, donde cada una de sus dimensiones corresponda a una de las secuencias, tal como se muestra en la siguiente figura.

Si observamos los paths 1 y 2 dibujados en las matrices de la figura podemos ver que se emplearon distintas estrategias para alinear este par de secuencias.
-
En 1 se eligió alinear los dos primeros nucleótidos TC por la diagonal, luego colocar un gap en la secuencia vertical TCCA y para finalizar se alinearon los nucleótidos CA restantes por la diagonal.
-
En 2 el primer nucleótido T de ambas secuencias se alineó por la diagonal, luego se colocó un gap en la secuencia vertical TCCA y finalmente se alinearon los 3 nucleótidos GCA y CCA restantes por la diagonal.
Si computamos los puntajes de ambos alineamientos, obtenemos que:
- La opción 1 tiene un puntaje de 2. Se propone colocar un único gap permitiendo alinear al resto de los nucleótidos en ambas secuencias con eventos de match.
- La opción 2 tiene un puntaje de 0. Las secuencias estudiadas se alinean con 1 gap, 1 mismatch y 3 matches. La estrategia es subóptima en relación a 1.
Pregunta
Si hubiésemos aplicado la metodología de dynamic programming para realizar un alineamiento global de estas secuencias, ¿cuál sería el path óptimo resultante?
A priori uno pensaría que es el path 1, pero hagamos el ejercicio para corroborar si esto es efectivamente así.
Para comenzar, refresquemos cómo funcionaba el método de dynamic programming.

Para llegar desde el extremo superior izquierdo (= inicio) de la matriz del alineamiento a la posición marcada con una x podríamos, hipotéticamente, tomar cualquiera de los caminos dibujados en la figura de más arriba. Estos paths darían alinemientos diferentes de las secuencias TC con TC.
Pregunta
Pero... ¿cuál es el procedimiento iterativo empleado por el método de dynamic programming para obtener el alineamiento óptimo entre dos secuencias?
Para llegar a cualquier celda de la matriz, uno puede acceder por, como máximo, 3 direcciones. La idea es siempre moverse en la dirección que maximice el score o puntaje.
Veamos que :
- un movimiento en la dirección horizontal, de la posición (i, j-1) a la posición (i, j), supone introducir un gap en la secuencia del eje vertical i
- un movimiento en la dirección diagonal, de la posición (i-1, j-1) a la posición (i, j), supone un match o un mismatch entre los nucleótidos enfrentados
- un movimiento en la dirección vertical, de la posición (i-1, j) a la posición (i, j), supone introducir un gap en la secuencia del eje horizontal j
Teniendo en cuenta la fórmula para obtener el score enunciada más arriba, podemos comenzar con nuestro ejercicio!
Recordemos que la matriz se llenará iterativamente, comenzando por la celda del extremo superior izquierdo, que tiene un puntaje de 0.

Para moverse del (0, 0) al (0, 1), hay una sóla opción, moverse en forma horizontal. Esto significa alinear T con un gap, lo cual da un score de 0 + (-2) = -2.
eje j: T
eje i: -
eje j: -
eje i: T
Para moverse del (0, 0) al (1, 1) hay 3 maneras:

1. Hacer un movimiento vertical, lo cual da un score de -2 + (-2) = -4
- -2 es el puntaje de la celda inicial (0, 1)
- El movimiento vertical implica colocar un gap: -2
Resultado:
eje j: T -
eje i: - T
2. Hacer un movimiento horizontal, lo cual da un score de -2 + (-2) = -4. Similar al caso anterior:
- -2 es el puntaje de la celda inicial (1, 0)
- El movimiento horizontal implica colocar un gap: -2
Resultado:
eje j: - T
eje i: T -
3. Hacer un movimiento diagonal, lo cual da un score de 0 + (+1). Implica alinear ambos nucléotidos!
- 0 es el puntaje de la celda inicial (0, 0)
- Hay T en las ambas secuencias. Es un match: +1
Resultado:
eje j: T
eje i: T
Para decidir qué valor ubicamos en la celda simplemente optamos por el que nos dé el mayor score, en este caso 1, y se marca el movimiento que lo produjo: un movimiento diagonal.
De esta manera podemos seguir completando la matriz,

Obsevando la última celda computada, podemos ver que hay nuevamente 3 maneras de llegar a la misma,
-
Hacer un movimiento vertical, de (1, 3) a (2, 3): Es decir, introducir un gap en la secuencia horizontal j. Si (1, 3) tiene un score de -3, el nuevo score es: -3 + gap penalty = -3 + (-2) = -5 (flecha en dirección vertical).
-
Hacer un movimiento horizontal, de (2, 2) a (2, 3). Es decir, introducir un gap en la secuencia vertical i. Si (2, 2) tiene un score de 2, el nuevo score es: 2 + gap penalty = 2 + (-2) = 0 (flecha en dirección horizontal).
-
Hacer un movimiento diagonal, de (1, 2) a (2, 3). Es decir, alinear los nucleótidos G y C. Si (1, 2) tiene un score de -1, el nuevo score es: -1 + mismatch = -1 + (-1) = -2 (flecha en dirección diagonal).
El máximo de los 3 scores calculados es: max(-5, 0, -2) = 0, que corresponde al puntaje del movimiento horizontal. Entonces colocamos 0 en la celda (2, 3) y una flecha horizontal que indique el movimiento de (2, 2) a (2, 3).
Al completar todas las celdas de la matriz, podemos saber cuál es el puntaje de la celda ubicada en extremo inferior derecho, que en este caso resultó ser +2. Este también es el puntaje final del alineamiento.

Para reconstruir el mismo, se parte de la celda ubicada en extremo inferior derecho y se siguen las flechas hasta llegar a la celda de inicio, en el extremo superior izquierdo.

Las flechas en rojo resaltan el path del alineamiento,
eje j: T C G C A
eje i: T C - C A
que podemos corroborar que es idéntico al path 1 del ejemplo que se planteó inicialmente.
Ejercicio 1
✏️ Paso 1
En grupo, realizá el alineamiento de las secuencias ATTGG con AGATGG, usando el esquema de puntajes: M=1, m=-1, g=-2.

✏️ Paso 2
Cuando termines el ejercicio anterior podés corrobar la solución que hallaste ingresando en UniFreiburg-FreiburgRNATools.
Seguí las siguientes instrucciones para usar este recurso web:
a. Ingresá las dos secuencias que querés alinear en los recuadros de Input Sequence a y Sequence b. Recordá que la secuencia que figura en tu matriz en sentido horizontal debe ser ingresada como Sequence b y la que figura en sentido vertical debe ser ingresada como Sequence a.
b. Seleccioná optimización de Similarity.
c. Completá los valores de tu esquema de scoring.
En el output podrás apreciar dos salidas:
-
A la izquierda, los valores de la matriz de alineamiento. Si cliqueas sobre los valores de la matriz, vas a observar que el valor sobre el que te paraste se colorea en verde, mientras que las celdas que dieron origen a ese valor se colorean en rosa.
-
A la derecha, se observa el alineamiento final, donde un match se esquematiza en con *, un mismatch con | y un gap con _.
✏️ Preguntas guía:
✏️ Pregunta 1
Reproducí el alineamiento que vimos como ejemplo al inicio (TCGCA con TCCA, esquema de puntajes: M=1, m=-1, g=-2) en la web de la UniFreiburg-FreiburgRNATools
¿Cuántas soluciones óptimas hay para este alineamiento? ¿Sucede lo mismo para el alineamiento que realizaste en el ✏️ Paso 1? ¿Por qué?
✏️ Pregunta 2
Observá con detenimiento el output del panel de la izquierda (la matriz)
Seleccioná una celda. ¿Qué sucede cuando cliqueás en una celda y se colorea en verde y la celda aledaña a la misma en rosa?
¿A qué corresponde este coloreado o resaltado de las celdas?
Observá nuevamente la matriz del alineamiento que obtuviste en 1.2. Cliquéa en la celda con puntaje -2 en la posición (A3, T2). Observá que se colorea en verde y dos celdas aledañas a la misma en rosa.
¿Entendés qué significa esto? ¿Podés relacionarlo con los dos caminos óptimos posibles que existen para este alineamiento?
Dot-Plots
Un Dot Plot (o gráfico de puntos) es una herramienta visual para comparar dos secuencias biológicas (ADN, ARN o proteínas).
¿Cómo funciona?
- Se colocan dos secuencias en los ejes X e Y.
- Se dibuja un punto (dot) en cada coordenada donde los caracteres (bases o aminoácidos) coinciden y tienen un puntaje mayor al Criterio de stringencia.
- Las diagonales en el gráfico indican regiones de similitud o alineamiento entre las secuencias.
Parámetros principales:
| Parámetro | ¿Qué hace? |
|---|---|
| Ventana (window) | Número de caracteres consecutivos que se comparan a la vez. |
| Criterio de stringencia (stringency) | Número mínimo de coincidencias dentro de la ventana para dibujar un punto. |
Ejercicio 2
Vamos a comparar dos secuencias de hemoglobina usando la herramienta online Dotlet.
✏️ Paso 1:
Dentro del superior de secuencias pegar las siguientes secuencias:
Secuencia 1:
MVLSPADKTNVKAAWGKVGAHAGEYGAEALERMFLSFPTTKTYFPHFDLSHGSAQVKGHGKKVADALTNAVAHVDDMPNALSALSDLHAHKLRVDPVNFK
Secuencia 2:
MVLSPADKTNVKAAWGKVGAHAGEYGAEALERMFLSFPTTKTYFPHFDLSHGSAQVKGHGKKVADALTNAVAHVDDMPNALSALSDLHAHKLRVDPVNFK
Qué hacer: - Configurá Window = 10 . - Hacé clic en "Draw".
Qué observar: Diagonal principal perfecta (100% identidad). No hay diagonales secundarias.
La matriz BLOSUM (BLOcks SUbstitution Matrix)
Es el estándar de facto para alinear proteínas. Fue creada por Henikoff y Henikoff en 1992.
Cómo funciona: - Tiene un valor específico para cada par de aminoácidos - No es binaria: cada una de las 190 sustituciones posibles tiene su propia puntuación - Los valores se basan en la probabilidad evolutiva de que ocurra cada cambio
¿Cómo se calculan los valores? - Se analizan bloques de alineamientos de proteínas reales - Se comparan dos frecuencias: 1. Frecuencia observada: con qué frecuencia ocurre esa sustitución en la naturaleza 2. Frecuencia esperada al azar: con qué frecuencia ocurriría si los aminoácidos se alinearan al azar - El resultado se expresa como un log-odds score: log2 (observado / esperado)
✏️ Paso 2:
Dentro del superior de secuencias pegar las siguientes secuencias:
Secuencia 1:
MVLSPADKTNVKAAWGKVGAHAGEYGAEALERMFLSFPTTKTYFPHFDLSHGSAQVKGHGKKVADALTNAVAHVDDMPNALSALSDLHAHKLRVDPVNFK
Secuencia 2:
MVLSPADKTNMVLSPADKTNGAHAGEYGAEALERMFLSFPTTKTYFPHFDLSHGSAQVKGHGKKVADALTNAVAHVDDMPNALSALSDLHAHKLRVDPVNFK
Explicación: La Secuencia 2 tiene el motivo "MVLSPADKTN" repetido al principio (20 aa), mientras que la Secuencia 1 lo tiene solo una vez. El resto de la secuencia (80 aa) es idéntico.
✏️ Paso 3:
Dentro del superior de secuencias pegar las siguientes secuencias:
Secuencia 1:
MVLSPADKTNVKAAWGKVGAHAGEYGAEALEEEEEEEEEEEEEEPHFDLSHGSAQVKGHGKKVADALTNAVAHVDDMPNALSALSDLHAHKLRVDPVNFK
Secuencia 2:
MVLSPADKTNVKAAWGKVGAHAGEYGAEALEEEEEEEEEEEEEEPHFDLSHGSAQVKGHGKKVADALTNAVAHVDDMPNALSALSDLHAHKLRVDPVNFK
Explicación: La Secuencias están compuestas por bloques de aminoácidos repetidos (E), lo que la hace de baja complejidad.
Qué observar: En la zona de baja complejidad , el dotplot se vuelve extremadamente denso, con múltiples diagonales paralelas y manchas de puntos que reflejan las repeticiones. La región de baja complejidad produce un patrón característico de "ruido" estructurado.
Ejercicio 3
Ahora vamos a generar el mismo dot plot pero desde la terminal usando dotmatcher del paquete EMBOSS.
Configuración de Google Colab
Google Colab es un entorno de desarrollo basado en la nube que permite escribir y ejecutar código en Python directamente desde el navegador, sin necesidad de instalar programas en la computadora. Al igual que otros IDEs (Integrated Development Environments), ofrece un espacio para escribir código, ejecutarlo, detectar errores (debuguear) y visualizar los resultados en un mismo lugar.
Una de las principales ventajas de Google Colab es que ya incluye instaladas muchas de las bibliotecas más utilizadas para el análisis de datos, como NumPy, Pandas, Matplotlib y Seaborn, además de permitir el uso gratuito de recursos de cómputo como GPU y TPU cuando es necesario. Asimismo, los cuadernos (notebooks) pueden compartirse fácilmente mediante un enlace, facilitando el trabajo colaborativo y la reproducción de análisis por parte de otros usuarios.
✏️ Paso 1
Abran Google Colab desde el navegador (Google Colab)
✏️ Paso 2
Creen un nuevo notebook haciendo click en Nuevo notebook en la parte superior
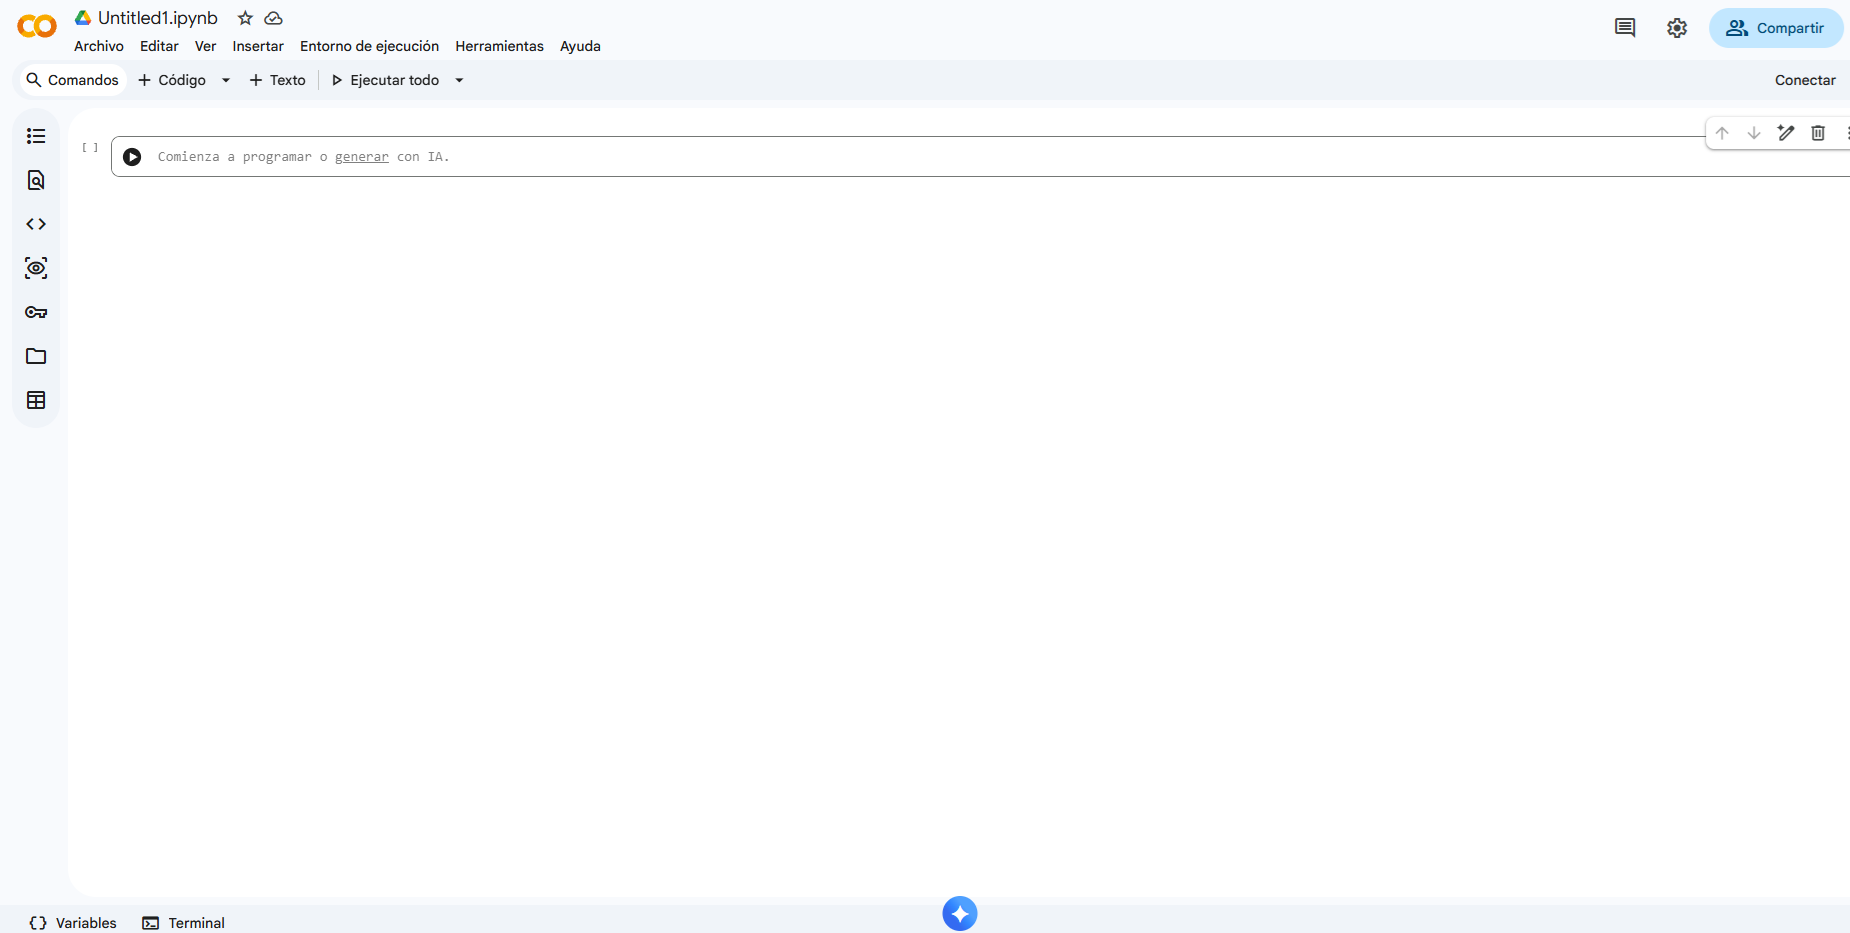
Ahora sí, deberían ver lo siguiente:
✏️ Paso 3
Verificar que estemos utilizando Python. Para ejecutar código, Google Colab debe estar conectado a un entorno de ejecución. Para comprobar el lenguaje seleccionado, vayan a Entorno de ejecución Cambiar tipo de entorno de ejecución. En la ventana que se abre, en Tipo de entorno de ejecución debería aparecer Python 3. Google Colab también permite ejecutar código en otros lenguajes, como por ejemplo, R. Si el entorno aún no está iniciado, hagan clic en Conectar (esquina superior derecha) para iniciar la sesión.
- Elementos principales de Google Colab
Celdas de código (zona central del notebook)
Las celdas de código contienen instrucciones en Python. Para ejecutarlas pueden hacer clic en el botón ▶ ubicado a la izquierda de la celda o presionar Shift+Enter, lo que además ejecuta la celda y selecciona la siguiente.
Celdas de texto (zona central del notebook)
Las celdas de texto permiten escribir explicaciones, títulos o consignas usando Markdown. En este trabajo práctico las utilizaremos para organizar el contenido y describir los ejercicios.
Panel de variables (zona inferior del notebook)
En el panel Variables pueden ver las variables que fueron creadas durante la ejecución del notebook. Esto resulta útil para inspeccionar datos y comprobar que el código está funcionando como esperan. A veces, este panel puede no actualizarse correctamente o no mostrar todas las variables creadas. Si esto ocurre, prueben a actualizar la página (f5). Sino pueden ejecutar el siguiente comando para listar todas las variables definidas en la sesión:
%whos
Archivos (barra lateral izquierda)
En la pestaña Archivos pueden explorar los archivos disponibles en la sesión de Colab y subir nuevos archivos desde su computadora. Más adelante utilizaremos esta pestaña para cargar los datos que analizaremos.
Terminal (zona inferior del notebook)
Google Colab también dispone de una terminal (Bash), desde la cual es posible ejecutar comandos del sistema operativo, de forma similar a la terminal que utilizamos en los trabajos prácticos anteriores. En este trabajo práctico utilizaremos las celdas de código para ejecutar programas en Python.
Guardar el notebook
Si modifican el notebook y desean conservar los cambios, pueden guardarlo en su cuenta de Google Drive usando Archivo → Guardar una copia en Drive.
Reiniciar el entorno
Las variables creadas en una sesión permanecen en memoria hasta que el entorno se reinicia. Si obtienen resultados inesperados, una buena práctica es ejecutar Entorno de ejecución → Reiniciar sesión y volver a correr las celdas desde el comienzo.
Uso del prefijo "!" en Google Colab para programar en Bash
Google Colab ejecuta su código sobre una máquina virtual con sistema operativo Linux. Gracias a esto, podemos interactuar directamente con la terminal usando el prefijo ! al inicio de cualquier línea dentro de una celda.
Instalación de paquetes y herramientas (ejemplo con EMBOSS)
Dado que el sistema operativo es Ubuntu, puedes instalar cualquier paquete disponible en sus repositorios usando apt-get con el prefijo ! y sudo. Por ejemplo, para instalar el paquete de bioinformática EMBOSS:
!sudo apt-get install paquete
Una vez instalado, puedes ejecutar sus herramientas directamente:
!dotmatcher -help # Muestra la ayuda del comando
El entorno de Colab es efímero. Al cerrar la sesión o tras un periodo de inactividad, la máquina se reinicia y se pierden todos los paquetes instalados. Por lo tanto, en cada nueva sesión deberás volver a ejecutar los comandos de instalación.
✏️ Paso 4
Ejecuten el siguiente comando para instalar EMBOSS
!sudo apt-get install emboss
Generación de Dotplots por línea de comando
✏️ Paso 5
Generá la estrcutura de directorios correspondiente y descargá la secuencia que vamos a comparar en esta sección ejecutando el siguiente comando:
!wget "https://bioinformatica-iib.github.io/introduccion_bioinformatica/practicos/TP03_Alineamientos/data/HS-ch1-fragment.fasta"
✏️ Paso 6
Generá un dotplot utilizando la secuencias descargada en el paso 1
!dotmatcher -graph pdf HS-ch1-fragment.fasta HS-ch1-fragment.fasta
Abrir el dotplot generado y observar el gráfico obtenido.
✏️ Paso 7
Para limpiar el plot y quedarnos con los matches más significativos podemos jugar con dos parámetros:
- windowsize: Tamaño de ventana
- threshold: Umbral de ocurrencia
Esto quiere decir que dotmatcher sólo va a poner un punto cuando un fragmento del largo windowsize contenga un score mayor a threshold.
Por ejemplo:
dotmatcher -graph pdf -windowsize 50 -threshold 20 HS-ch1-fragment.fasta HS-ch1-fragment.fasta
Cambiá los parámetros windowsize y threshold hasta obtener un plot que te parezca adecuado. ¿Qué podés interpretar del mismo? Identificá patrones.
Ejercicio 4
Hasta ahora trabajamos con los algoritmos de alineamiento de forma casi manual, entendiendo cómo funcionan por dentro los algoritmos.
Ahora vamos a dar un paso más: vamos a utilizar los algoritmos de alineamiento por línea de comandos.
Para eso vamos a usar EMBOSS (European Molecular Biology Open Software Suite), un paquete de software que diseña programas específicos para poder ejecutar desde la terminal y analizar secuencias biológicas de forma automatizada. Esto es lo que se usa en la práctica real cuando tenemos que procesar muchas secuencias o queremos integrar los análisis en flujos de trabajo (pipelines).
Consigna: Determinar qué especies están más relacionadas utilizando la ribonucleasa pancreática de caballo (Equus caballus), ballena enana (Balaenoptera acutorostrata) y canguro rojo (Macropus rufus).

✏️ Paso 1
Descargá los materiales de este TP ejecutando los siguientes comandos:
wget "https://bioinformatica-iib.github.io/introduccion_bioinformatica/practicos/TP03_Alineamientos/data/Balaenoptera_acutorostrata.fasta"
wget "https://bioinformatica-iib.github.io/introduccion_bioinformatica/practicos/TP03_Alineamientos/data/Macropus_rufus.fasta"
wget "https://bioinformatica-iib.github.io/introduccion_bioinformatica/practicos/TP03_Alineamientos/data/Equus_caballus.fasta"
✏️ Paso 2
Utilizá la herramienta de alineamiento global de EMBOSS needle (pueden leer el manual para ver que opciones admite ejecutnado el comando man needle) para comparar las tres secuencias de a pares.
needle -gapopen 10 -gapextend 1 -asequence *secuencia_1* -bsequence *secuencia_2* -outfile *salida*
✏️ Paso 4
Observá e interpretá las salidas obtenidas.
La salida contiene la siguiente información
| Concepto | Definición |
|---|---|
| Identidad | Porcentaje de aminoácidos exactamente iguales |
| Similitud | Porcentaje de aminoácidos idénticos o similares (cambios conservados) |
| Gap | Hueco introducido para optimizar el alineamiento (indica inserción/deleción) |
| Score | Puntuación total (matches - penalizaciones por gaps) |
| Alineamiento global | Alinea las secuencias de principio a fin (Needleman-Wunsch) |
- ¿Qué secuencias son más similares?
✏️ Paso 5
Analizá árbol filogenético de la Fig. 1 del paper de O'Leary et al., 2013. Sabiendo que los caballos y las ballenas pertenecen al clado Euungulata y los canguros al clado Marsupialia, ubicá estos clado en el árbol.
- ¿Esta información coincide con los resultados que obtuviste en el anterior?
Identidad, Similitud y Homología
Los términos identidad, similitud y homología se suelen utilizar como sinónimos por muchos investigadores, sin embargo no lo son.
-
La identidad es una es una característica cuantitativa de un par de secuencias, donde se cuenta cuántos elementos (residuos, nucleótidos, aminoácidos etc) son idénticos entre ambas secuencias después de alinearlas.
-
La similitud es una característica cuantitativa de un par de secuencias, donde se establece en qué grado estas se parecen (por ejemplo aplicando los algoritmos antes vistos, utilizando un sistema de puntaje) después de alinearlas.
-
La homología, por otro lado, es una característica cualitativa, dos secuencias SON o NO SON homólogas. Homología implica específicamente que el par de secuencias estudiadas provienen de un mismo ancestro común. Esta afirmación es completamente hipotética, ya que, salvo en contados casos, no se puede corroborar. Uno puede inferir que este es el caso dado la similitud observada en las secuencias actuales, sin tener acceso a las secuencias ancestrales.
Atención
Decir que un par de secuencias tiene N% de homología es TOTALMENTE incorrecto.
A partir de esta relación entre similitud y homología se pueden inferir relaciones entre diferentes especies, buscar posibles funciones de una secuencia desconocida, etc.
Ejercicio a informar
Info
Fecha límite de entrega: Viernes, 28 de agosto 2026, 23:59hs.
Enviar a mdidiergarnham@iib.unsam.edu.ar, incluyendo en copia a jglavina@iib.unsam.edu.ar y al resto de los miembros del grupo.
Contexto biológico
El virus del dengue (DENV) es un arbovirus de la familia Flaviviridae, transmitido por mosquitos del género Aedes (principalmente Aedes aegypti). Existen cuatro serotipos (DENV‑1, DENV‑2, DENV‑3 y DENV‑4) que circulan simultáneamente en regiones endémicas. La infección por un serotipo genera inmunidad duradera solo contra ese serotipo, y una segunda infección por un serotipo diferente aumenta el riesgo de dengue grave (dengue hemorrágico o síndrome de shock).
El virus Zika (ZIKV) es otro flavivirus estrechamente relacionado, transmitido por el mismo vector. Comparte aproximadamente un 55‑60 % de identidad nucleotídica con el dengue en el gen de la envoltura (E), lo que causa reactividad cruzada en pruebas serológicas y hace esencial la confirmación molecular.
El gen de la envoltura (E) es el principal objetivo para la genotipificación y el diseño de vacunas, ya que contiene los epitopos neutralizantes y es la región más variable entre serotipos.
En este práctico, usted recibirá tres muestras clínicas secuenciadas (archivo secuencia_incognita.fasta). Deberá determinar si corresponden a dengue, a Zika o si la secuenciación ha fallado. Para ello, comparará las secuencias problema con un conjunto de referencias de los cuatro serotipos de dengue (archivo all_sequences.fasta).
Archivos de trabajo
A continuación se listan los archivos necesarios para el práctico.
- dengue_sequences.fasta – Secuencias de referencia de los cuatro serotipos de dengue (DENV‑1 a DENV‑4).
!wget "https://bioinformatica-iib.github.io/introduccion_bioinformatica/practicos/TP03_Alineamientos/data/informe/dengue_sequences.fasta"
- secuencia_incognita.fasta – Contiene las tres muestras clínicas a analizar (Paciente_001, Paciente_002, Paciente_003).
!wget "https://bioinformatica-iib.github.io/introduccion_bioinformatica/practicos/TP03_Alineamientos/data/informe/secuencia_incognita.fasta"
- zika_reference.fasta – Secuencia de referencia del virus Zika.
!wget "https://bioinformatica-iib.github.io/introduccion_bioinformatica/practicos/TP03_Alineamientos/data/informe/zika_reference.fasta"
Tip: Si necesita dividir el archivo
secuencia_incognita.fastaen archivos individuales, use el comando!seqretsplit secuencia_incognita.fasta(EMBOSS).
Consignas
1. Identificación de especie y, si corresponde, de serotipo
Utilizando la herramienta de alineamiento global needle (EMBOSS), compare cada una de las tres muestras de pacientes contra cada una de las seferencias (DENV‑1, DENV‑2, DENV‑3, DENV‑4 y ZIKV).
Para cada muestra, registre el % de identidad obtenido contra cada una de las referencias y arme una tabla comparativa.
A partir de esa tabla, responda:
- ¿Alguna de las muestras corresponde al virus dengue? ¿A cuál/cuáles?
- ¿Alguna corresponde a Zika en lugar de a dengue? ¿Cómo lo determinó a partir de los porcentajes de identidad?
- Para las muestras que resultaron ser dengue, ¿a qué serotipo pertenece cada una? ¿Qué porcentaje de identidad considera suficiente para asignar un serotipo? (Investigue el criterio del 90 % de identidad en la región E usado en la literatura).
- ¿Alguna muestra no muestra una identidad clara con ninguna de las cinco referencias? En ese caso, ¿qué explicación biológica o técnica propondría (por ejemplo, falla de secuenciación, contaminación, calidad de la muestra)?
2. Análisis por dotplot y región variable
Seleccione la/las muestra que resultaron ser dengue y compárela, mediante un dotplot (puede usar dotmatcher de EMBOSS o la herramienta web Dotlet), con el resto de las variantes.
- ¿Observa regiones de alta similitud y regiones de baja similitud?
- Identifique una región de aproximadamente 100‑200 pb donde el dotplot muestre claramente diferencias (por ejemplo, un gap o una zona con pocos puntos).
- ¿Cómo podría aprovechar esa región para diseñar un ensayo de PCR específica para el serotipo encontrado?
3. (Opcional) Automatización con script en Bash
Si desea, puede escribir un script de Bash que:
- Divida
secuencia_incognita.fastaen archivos individuales. - Realice un doble bucle
for(muestra × referencia) para alinear cada paciente con cada una de las 5 referencias usandoneedle. - Genere automáticamente un dotplot en formato PDF con
dotmatcher(use-graph pdfy-goutfile grafico) para la muestra dengue identificada, contra dos serotipos de referencia.
??? info "Posible estructura del script":
#!/usr/bin/env bash
echo -e "Paciente\tdenv1" > resultados.tsv

for paciente in paciente*.fasta; do
    needle -gapopen 10 -gapextend 1 -asequence "$paciente" -bsequence denv1_reference_e_gene.fasta -outfile "${paciente}_vs_denv1.txt"
    # Repetir para todas las secuencias de referencia

    identidad_denv1=$(grep "^# Identity:" "${paciente}_vs_denv1.txt")
    echo -e "{$paciente}\t{$identidad_denv1}" >> resultados.tsv
    # Repetir para todas las secuencias de referencia

    dotmatcher -windowsize 50 -threshold 20 -asequence "$paciente" -bsequence "denv1_reference_e_gene.fasta" -graph pdf -goutfile "dotplots/${paciente}_vs_denv1_reference_e_gene.fasta"
    # Repetir para todas las secuencias de referencia
done
Recuerden utilizar una estructura de directorios ordenadas para trabajar.
Incluyan el script como parte de su entrega adjuntando el link a la notebook (no obligatorio, pero sumará puntos).